                            class Algorithms {
                            public:
                                Algorithms lecture {
                                    .author = "Р.А. Нестеров"
                                    .year = "2026/27"
                                    .course = "НИУ ВШЭ ПИ, 2 курс"
                                };
алгоритмы
и структуры данных
                                // 01. Алгоритм Лас-Вегас со случайной сложностью
                                void quick_sort(Iter first, Iter last);
                                void expected_comparisons();
                                // 02. ADT Очередь с приоритетами и пирамидальная сортировка
                                template<typename T> class PriorityQueue {...};
                                void heap_sort(std::vector& vec);
                                // 03. Сортировки на сравнениях [cb-сортировки] и граница оптимальности
                                void build_decision_tree();
                                void comparisons_lower_bound();
->06
06.00
краткая ретроспектива и повторение
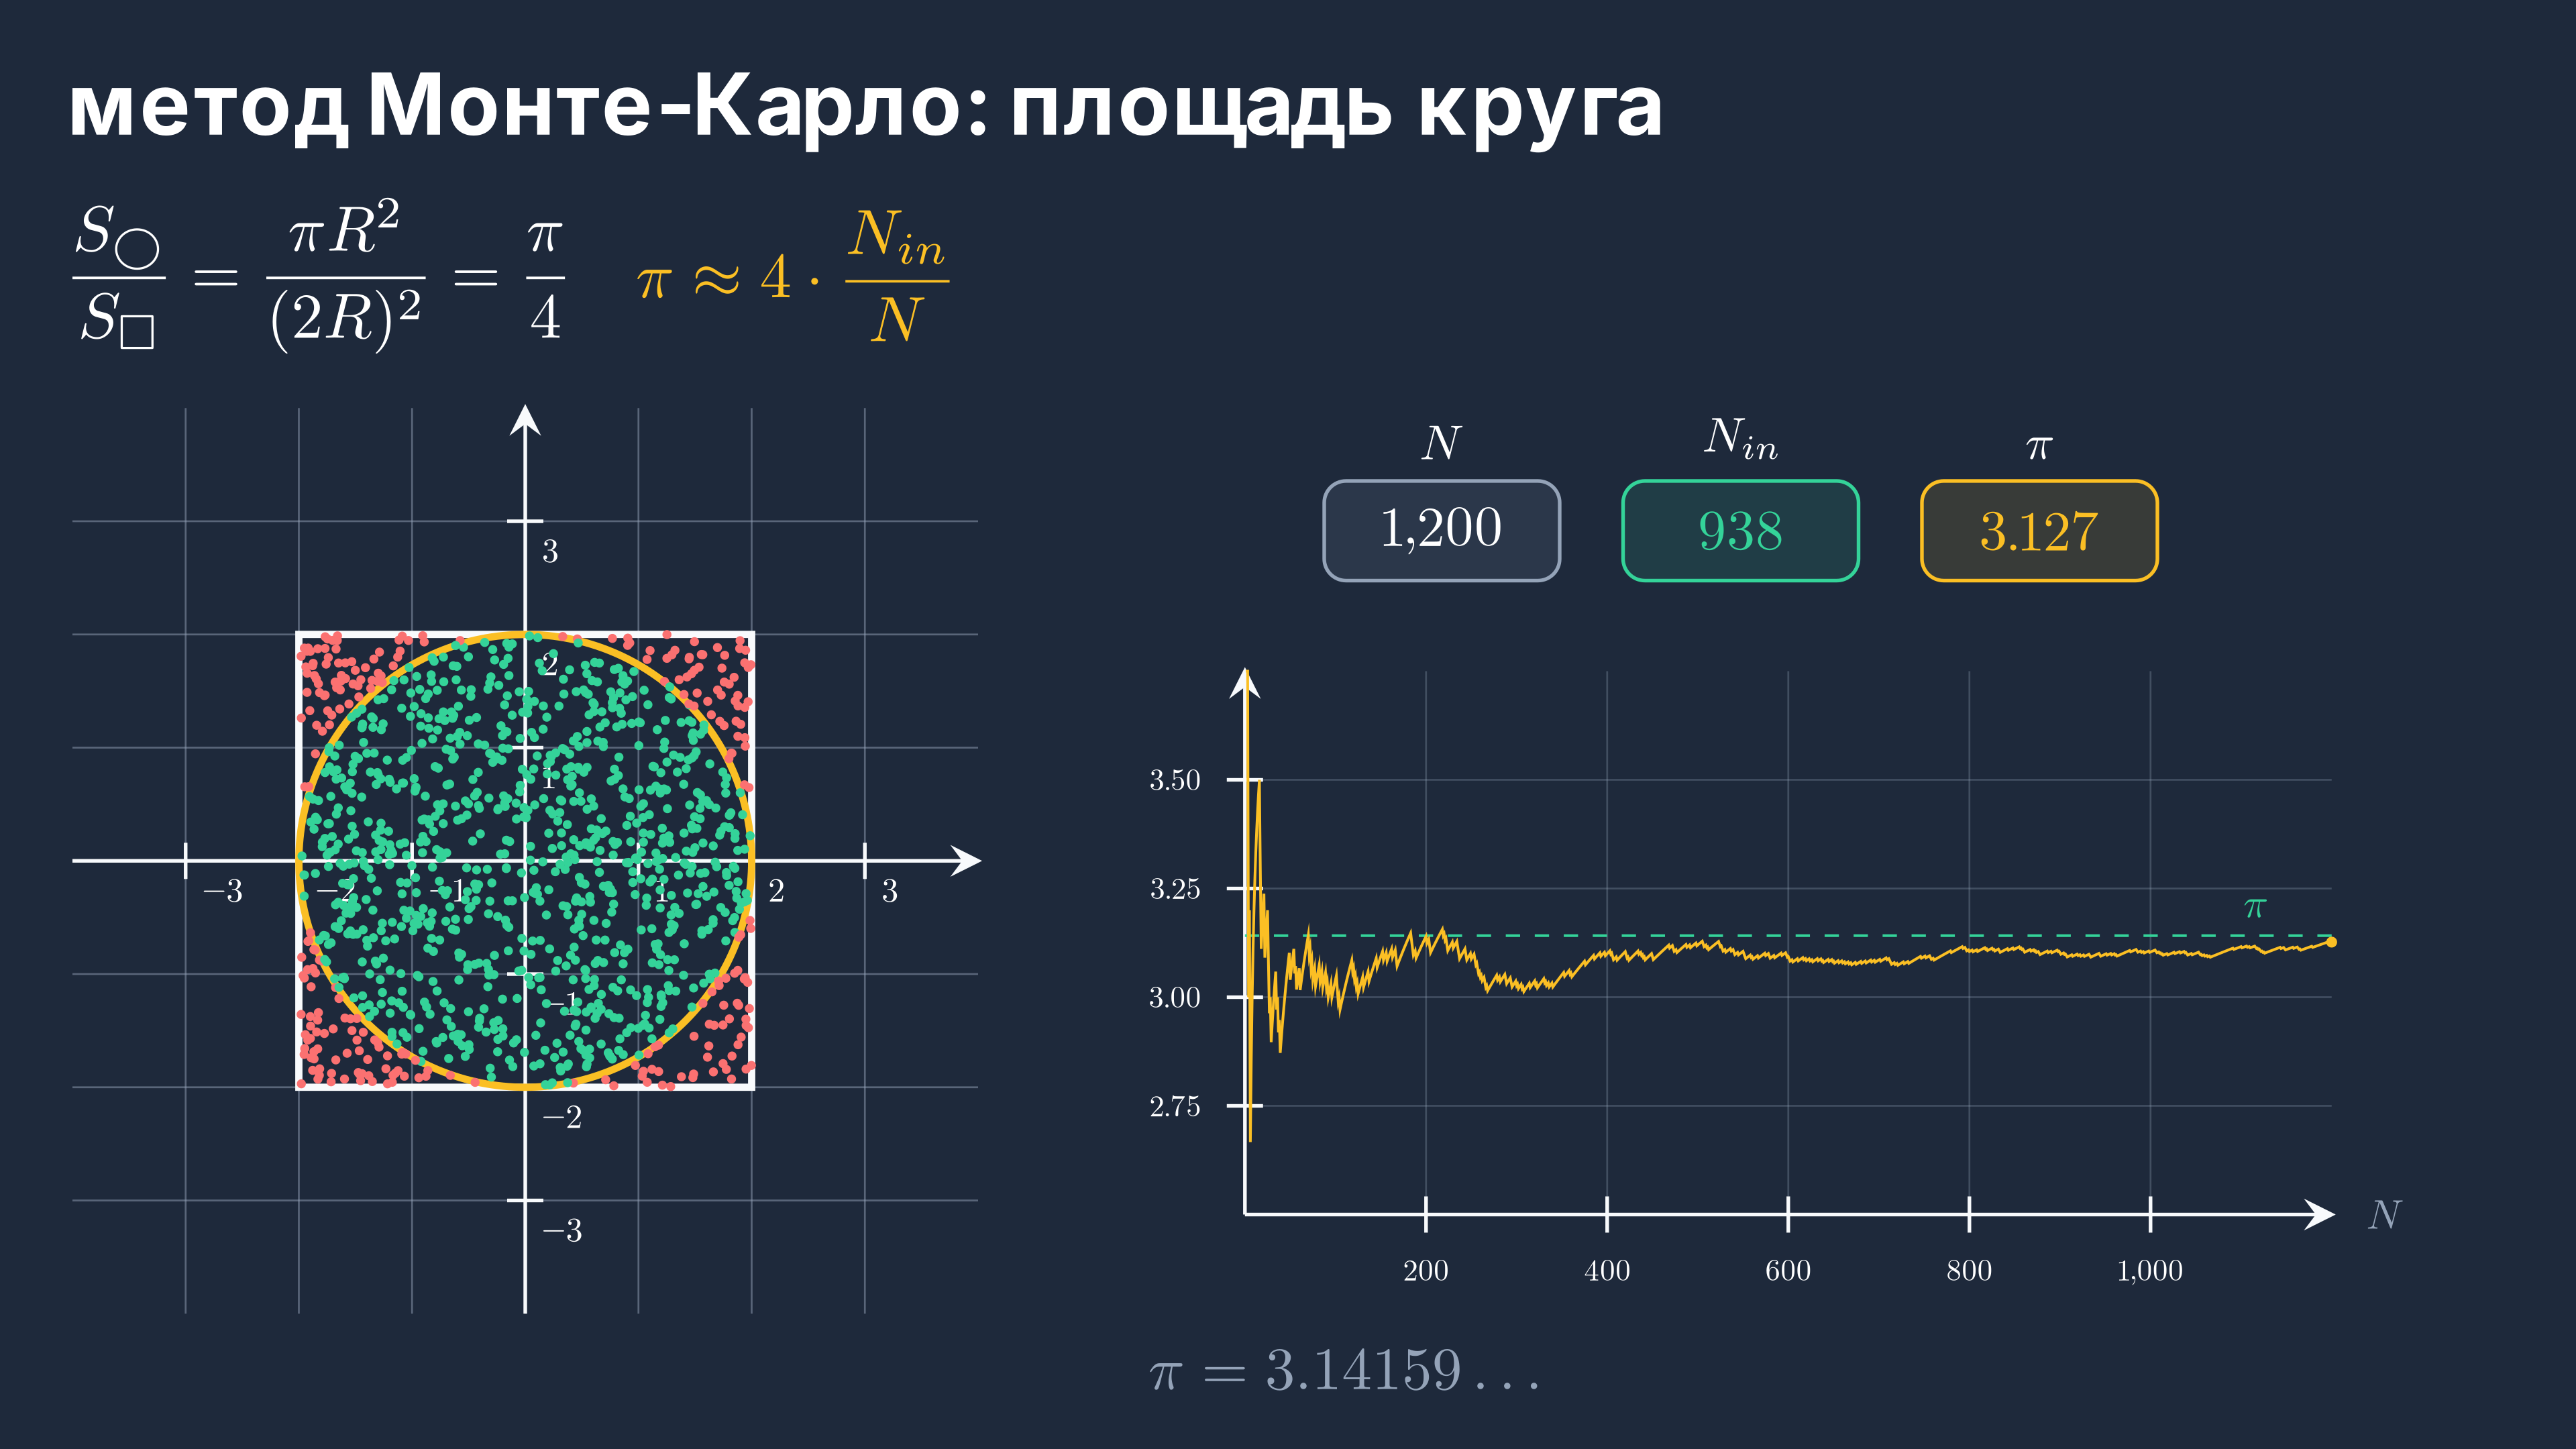
метод Монте-Карло: проба пространства
проверка корректности матричного умножения
за $\mathrm{O}(n^2)$ c приемлемой вероятностью ошибки
задача 06.01
на проверку поступили три матрицы:
$A = \begin{pmatrix} 1 & 2 \\ 3 & 4 \end{pmatrix} B = \begin{pmatrix} 5 & 6 \\ 7 & 8 \end{pmatrix} C = \begin{pmatrix} \textcolor{#FB7171}{18} & 22 \\ 43 & 50 \end{pmatrix}$
- в матрице $C$ были допущены ошибки
-
необходимо установить истинность $AB = C$ за $\mathrm{O}(n^2)$,
не пересчитывая результат $AB$ заново
решение — идея Русиньша фрейвальдса
определим матрицу ошибок $D$:
$D = AB - C = \begin{pmatrix} \textcolor{#FB7171}{\Delta} & 0 \\ 0 & 0 \end{pmatrix}$
умножаем матрицу ошибок $D$ на случайный бинарный вектор-детектор $r = (r_1 \,\, r_2)^T$, то есть, $r \in \{0, 1\}^2$:
$Dr = \begin{pmatrix} \textcolor{#FB7171}{\Delta} & 0 \\ 0 & 0 \end{pmatrix} \cdot \begin{pmatrix} r_1 \\ r_2 \end{pmatrix} = \begin{pmatrix} \textcolor{#FB7171}{\Delta}\cdot r_1 \\ 0 \end{pmatrix}$
- если $r_1 = 1$, то $Dr = (\textcolor{#FB7171}{\Delta}\,\,0)^T \neq 0$, ошибка обнаружена!
- если $r_1 = 0$, то $Dr = (0\,\,0)^T \neq 0$, ошибка скрылась...
неделя №6
--> квиз Л5
06.01
алгоритм Лас-Вегас
схема быстрой сортировки
выбор опорного элемента и его влияние
на сложность сортировки
экспериментальная оценка
                                        #include <iostream>
                                        #include <vector>
                                        #include <algorithm>
                                        #include <iterator>

                                        template<typename Iter>
                                        void merge_sort(Iter first, Iter last) {
                                            if (std::distance(first, last) <= 1) return;
                                            auto mid = first + std::distance(first, last) / 2;

                                            merge_sort(first, mid);
                                            merge_sort(mid, last);
                                            merge(first, mid, last);
                                        }

                                        int main() {
                                            std::vector<int> arr = {5, 2, 4, 6, 1, 3};
                                            merge_sort(arr.begin(), arr.end());

                                            std::cout << std::boolalpha;
                                            std::cout << std::is_sorted(arr.begin(), arr.end());
                                        }
#include <iostream>
#include <vector>
#include <algorithm>
#include <iterator>

template<typename Iter>
void quick_sort(Iter first, Iter last) {
    if (std::distance(first, last) <= 1) return;

    auto pivot_pos = partition(first, last);

    quick_sort(first, pivot_pos);
    quick_sort(std::next(pivot_pos), last);
}

int main() {
    std::vector<int> arr = {5, 2, 4, 6, 1, 3};
    quick_sort(arr.begin(), arr.end());

    std::cout << std::boolalpha;
    std::cout << std::is_sorted(arr.begin(), arr.end());
}
#include <iostream>
#include <vector>
#include <algorithm>
#include <iterator>

template<typename Iter>
void quick_sort(Iter first, Iter last) {
    if (std::distance(first, last) <= 1) return;

    auto pivot_pos = partition(first, last);

    quick_sort(first, pivot_pos);
    quick_sort(std::next(pivot_pos), last);
}

int main() {
    std::vector<int> arr = {5, 2, 4, 6, 1, 3};
    quick_sort(arr.begin(), arr.end());

    std::cout << std::boolalpha;
    std::cout << std::is_sorted(arr.begin(), arr.end());
}
выбор опорного элемента
функция partition выбирает опорный элемент и распределяет элементы массива относительно него
- фиксированный элемент [ первый / последний ]
- медиана трех элементов [ первый, последний и средний ]
-
элемент, делящий массив в соотношении $a \div b$
[ специальный алгоритм выбора опорного элемента ] - случайно выбранный элемент
сложность зависит от pivot
общее соотношение: $T(n) = T(n-c) + T(c) + kn$
- $T_{\text{worst}}(n) = T(1) + T(n - 1)+kn$ $=\mathrm{O}(n^2)$
- $T_{\text{best}}(n) = 2\cdot T(n\,/\,2)+ kn$ $=\mathrm{O}(n \log n)$
- $T_{\text{avg}}(n) = T\left(\dfrac{an}{a+b} \right) + T\left(\dfrac{bn}{a+b} \right)+ kn$ $= \dots$
void expected_comparisons();
$T_{\text{avg}}(n)$ для быстрой сортировки
оценка математического ожидания числа сравнений
утверждение 06.01
$\mathbb{E}[X] \leqslant 2n \ln n \approx 1.39 n \log_2 n$
доказательство — шаг 1
- $A = [a_1, a_2, \dots, a_n]$ — исходный массив
- $s_1 \leqslant s_2 \leqslant \dots \leqslant s_n$ — упорядоченные элементы $A$
введем индикаторную случайную величину $X_{ij}$ для каждой пары элементов $s_i$ и $s_j$, где $i < j$: $ X_{ij} = \begin{cases} 1, & \text{если } s_i \text{ и } s_j \text{ сравнивались} \\ 0, & \text{в противном случае} \end{cases} $
общее количество сравнений $X$ — сумма индикаторов: $ X = \displaystyle\sum_{i=1}^{n-1} \sum_{j=i+1}^{n} X_{ij} $
void expected_comparisons();
$T_{\text{avg}}(n)$ для быстрой сортировки
оценка математического ожидания числа сравнений
утверждение 06.01
$\mathbb{E}[X] \leqslant 2n \ln n \approx 1.39 n \log_2 n$
вспомогательные нотации
- $s_1 \leqslant s_2 \leqslant \dots \leqslant s_n$ — упорядоченные элементы $A$
- $ X_{ij} = \begin{cases} 1, & \text{если } s_i \text{ и } s_j \text{ сравнивались} \\ 0, & \text{в противном случае} \end{cases} $
доказательство — шаг 2
выразим математическое ожидание $X$: $\displaystyle \mathbb{E}[X] = \mathbb{E}\left[ \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} X_{ij} \right] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} \mathbb{E}[X_{ij}]$
величина $X_{ij}$ распределена по закону Бернулли, поэтому: $\displaystyle \mathbb{E}[X_{ij}] = 1 \cdot P(X_{ij} = 1) + 0 \cdot P(X_{ij} = 0) = P(s_i \leftrightarrow s_j)$
таким образом, целевое уравнение для $\mathbb{E}[X]$: $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} P(s_i \leftrightarrow s_j)$
void expected_comparisons();
$T_{\text{avg}}(n)$ для быстрой сортировки
оценка математического ожидания числа сравнений
утверждение 06.01
$\mathbb{E}[X] \leqslant 2n \ln n \approx 1.39 n \log_2 n$
вспомогательные нотации
- $s_1 \leqslant s_2 \leqslant \dots \leqslant s_n$ — упорядоченные элементы $A$
- $ X_{ij} = \begin{cases} 1, & \text{если } s_i \text{ и } s_j \text{ сравнивались} \\ 0, & \text{в противном случае} \end{cases} $
- $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} P(s_i \leftrightarrow s_j)$
доказательство — шаг 3
рассмотрим множество $S_{ij}$ элементов между $s_i$ и $s_j$: $\displaystyle S_{ij} = \{s_i, s_{i+1}, \dots, s_j\}$ — отрезок упорядоченных элементов $A$
необходимо определить, когда элементы $s_i$ и $s_j$ сравниваются в разных ситуациях выбора опорного элемента:
- выбор pivot за пределами $S_{ij}$ — не сравниваются
- выбор pivot внутри $S_{ij}$ разделяет $s_i$ и $s_j$ — не сравниваются
- выбор pivot на границах $S_{ij}$ приведет к сравнению $s_i$ и $s_j$
вероятность выбрать именно $s_i$ или $s_j$: $\displaystyle P(s_i \leftrightarrow s_j) = \frac{2}{j - i + 1}$, поскольку выбор равновероятен
void expected_comparisons();
$T_{\text{avg}}(n)$ для быстрой сортировки
оценка математического ожидания числа сравнений
утверждение 06.01
$\mathbb{E}[X] \leqslant 2n \ln n \approx 1.39 n \log_2 n$
вспомогательные нотации
- $s_1 \leqslant s_2 \leqslant \dots \leqslant s_n$ — упорядоченные элементы $A$
- $ X_{ij} = \begin{cases} 1, & \text{если } s_i \text{ и } s_j \text{ сравнивались} \\ 0, & \text{в противном случае} \end{cases} $
- $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} P(s_i \leftrightarrow s_j)$
доказательство — шаг 4
подставим найденную вероятность в сумму для $\mathbb{E}(X)$: $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} P(s_i \leftrightarrow s_j) = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} \frac{2}{j - i + 1}$
выполним замену $k = j - i + 1$ — когда $j$ идет от $i+1$ до $n$, переменная $k$ будет изменяться от $2$ до $n - i + 1$: $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{k=2}^{n-i+1} \frac{2}{k}$
для упрощения оценки расширим границы суммирования: $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{k=2}^{n-i+1} \frac{2}{k} \le \sum_{i=1}^{n} \sum_{k=1}^n \frac{2}{k} = 2 \sum_{i=1}^{n} \sum_{k=1}^n \frac{1}{k}$
void expected_comparisons();
$T_{\text{avg}}(n)$ для быстрой сортировки
оценка математического ожидания числа сравнений
утверждение 06.01
$\mathbb{E}[X] \leqslant 2n \ln n \approx 1.39 n \log_2 n$
вспомогательные нотации
- $s_1 \leqslant s_2 \leqslant \dots \leqslant s_n$ — упорядоченные элементы $A$
- $ X_{ij} = \begin{cases} 1, & \text{если } s_i \text{ и } s_j \text{ сравнивались} \\ 0, & \text{в противном случае} \end{cases} $
- $\displaystyle \mathbb{E}[X] = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} P(s_i \leftrightarrow s_j) \leqslant 2 \sum_{i=1}^{n} \sum_{k=1}^n \frac{1}{k}$
доказательство — шаг 5
вспомним сумму гармонического ряда: $\displaystyle H_n = \sum_{k=1}^{n} \frac{1}{k} = \ln n + \gamma + O\left(\frac{1}{n}\right)$
подставим $H_n$ вместо внутренней суммы в $E(X)$: $\displaystyle E[X] \le 2 \sum_{i=1}^{n} \sum_{k=1}^{n} \frac{1}{k} = 2 \sum_{i=1}^{n} H_n = 2n \cdot H_n$
таким образом, с учетом перехода к двоичному логарифму:
$\begin{aligned} \mathbb{E}[X] \leqslant 2n (\ln n + \Theta(1)) & = 2n \ln n + \Theta(n) \end{aligned}$
$\begin{aligned} \phantom{\mathbb{E}[X] \leqslant 2n (\ln n + \Theta(1))} & = 2n \frac{\log_2 n}{1.4426} + \Theta(n) \end{aligned}$
$\begin{aligned} \phantom{\mathbb{E}[X] \leqslant 2n (\ln n + \Theta(1)) } & \approx 1.39 n \log_2 n \end{aligned}$
| Алгоритм | 1 000 | 5 000 | 10 000 | 50 000 | 100 000 | Комментарий |
|---|---|---|---|---|---|---|
| std::sort BEST | 5.4 | 29.9 | 65.7 | 565.3 | 1 273.1 | introsort (гибридный алгоритм) |
| qs_median GOOD | 7.3 | 46.0 | 199.6 | 1 719.7 | 3 589.6 | медиана трёх: баланс скорости и защиты от $\mathrm{O}(n^2)$ |
| qs_last OK | 8.7 | 71.7 | 184.1 | 1 742.6 | 3 746.8 | последний элемент как pivot |
| qs_first OK | 10.6 | 99.3 | 255.0 | 1 820.8 | 3 895.3 | первый элемент как pivot |
| qs_random SLOW | 15.8 | 98.9 | 297.3 | 2 150.2 | 4 796.5 | случайный pivot: накладные расходы |
| merge_sort SLOWEST | 35.6 | 214.6 | 449.3 | 2 485.1 | 5 186.2 | $\mathrm{O}(n)$ памяти и копирование в буфер при слиянии |
*время в наносекундах, необходимое для сортировки случайных массивов, различных размеров [результаты статистически стабильны]
06.02
ADT Очередь
с приоритетами
внутренняя реализация интерфейса очереди с приоритетами: одномерный массив
двухэтапная сортировка HEAP SORT на основе
очереди с приоритетами
                                        template<typename Key>
                                        class PriorityQueue {
                                        public:
                                            // вставка с учетом приоритета
                                            void push(Key val);

                                            // доступ и удаление элемента с
                                            // самым высоким приоритетом
                                            Key pop();
                                            Key top();

                                            // изменение приоритета
                                            void change_priority(Key old, Key new);

                                        private:
                                            // внутренний контейнер
                                        }
неупорядоченный список
- быстрый push()
- медленный pop()/top()
упорядоченный список
- медленный push()
- быстрый pop()/top()
бинарное дерево поиска
- проблемы несбалансированности
- упорядоченное хранение ключей-приоритетов
сбалансированное дерево поиска
- затраты на балансировку
- упорядоченное хранение ключей-приоритетов

                                        Key PriorityQueue<Key>::top() {
                                            // поиск самого приоритетного значения
                                            for (int pri = 0; pri < M; ++pri) {
                                                if (!queues_[pri].empty()) {
                                                    return queues_[pri].front();
                                                }
                                            }
                                        }
мульти-очередь
- быстрый push() — $\Theta(1)$
- медленный pop()/top() — $\mathrm{O}(M)$
выбор индексированного хранения очередей непрактичен при заранее неизвестном количестве приоритетов
template<typename Key> class PriorityQueue { ... }
бинарная куча
основной способ реализации интерфейса очереди с приоритетами
полное бинарное дерево высоты
- уровни дерева заполняются по порядку слева направо
-
приоритет (ключ) в родительском узле больше
[ меньше ] приоритета обоих потомков

                                        int parent(int i) { return i / 2; }

                                        int left(int i) { return 2 * i; }

                                        int right(int i) { return 2 * i + 1; }


вставка в очередь с приоритетами
-
новый элемент вставляется на первое свободное место
[ в конец массива heap_ ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]


вставка в очередь с приоритетами
-
новый элемент вставляется на первое свободное место
[ в конец массива heap_ ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]


вставка в очередь с приоритетами
-
новый элемент вставляется на первое свободное место
[ в конец массива heap_ ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]
              // восстановление инварианта кучи снизу вверх
              void swim_up(int k) {
                  while ((k > 1) && (heap_[k / 2] < heap_[k])) {
                      std::swap(heap_[k / 2], heap_[k]);
                      k = k / 2;
                  }
              }


удаление из очереди с приоритетами
-
корень замещается последним элементом массива heap_
[ удаляется минимум или максимум ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]


удаление из очереди с приоритетами
-
корень замещается последним элементом массива heap_
[ удаляется минимум или максимум ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]


удаление из очереди с приоритетами
-
корень замещается последним элементом массива heap_
[ удаляется минимум или максимум ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]


удаление из очереди с приоритетами
-
корень замещается последним элементом массива heap_
[ удаляется минимум или максимум ] - при нарушении инварианта кучи его необходимо восстановить [ в зависимости от принятого варианта ]
              // восстановление инварианта кучи сверху вниз
              void sink_down(int k) {
                  while (2 * k <= n) {
                      int j = 2 * k;
                      if ((j < n) && (heap_[j] < heap[j + 1])) ++j;
                      std::swap(heap_[k], heap[j]);
                      k = j;
                  }
              }


утверждение 06.02 — высота дерева определяет сложность
                                        #include <algorithm>
                                        #include <vector>
                                        #include <iostream>

                                        void heap_sort(std::vector<int>& arr) {
                                            std::make_heap(arr.begin(), arr.end());
                                            std::sort_heap(arr.begin(), arr.end());
                                        }

                                        int main() {
                                            std::vector<int> vec{8, 3, 1, 7, 4, 2, 6, 5};
                                            heap_sort(vec.begin(), vec.end());
                                            std::cout << std::is_sorted(vec.begin(), vec.end());
                                        }
пирамидальная сортировка
-
создание бинарной кучи на базе исходного массива
[ линейные временные затраты $\mathrm{O}(n)$ ] -
перемещение корня кучи в конец и восстановление инварианта для каждого элемента
[ общие временные затраты — $\mathrm{O}(n \log n)$ ]
06.03
сортировки на сравнениях
общая модель сортировки: дерево решений
нижняя граница сравнений: критерий оптимальности сортировок
void build_decision_tree();
дерево решений для сортировки
общая модель вычислений в сортировке на сравнениях [ cb-сортировке ]
конфигурация дерева решений
- выполнение алгоритма cb-сортировки — это путь из корня до листа в дереве решений
- нижняя граница высоты дерева — это минимально необходимое количество сравнений для сортировки
void comparisons_lower_bound();
дерево решений для сортировки
явная оценка высоты дерева решений cb-сортировки
утверждение 06.03
доказательство
- дерево решений имеет $n!$ листьев по числу перестановок
-
бинарное дерево высоты $h$
имеет не более $2^h$ листьев: $ 2^h \geqslant n! \Rightarrow h \geqslant \log_2 n! $ - применим формулу Стирлинга $n! > (n\,/\,e)^n$: $ h \geqslant \log_2 n! \Rightarrow h \geqslant \log_2 (n\,/\,e)^n \Rightarrow h \geqslant n \log_2 n - n \log_2 e$
ответ $h = \Omega(n \log n)$ при $c = 0.5$ и достаточно больших $n$
void comparisons_lower_bound();
дерево решений для сортировки
явная оценка высоты дерева решений cb-сортировки
утверждение 06.03
ключевое следствие
- алгоритм сортировки merge_sort является оптимальным
- алгоритм сортировки heap_sort является оптимальным
06.04
контрольная работа №1
задачи и вопросы
ограничения и возможности
дата и содержание КР №1
19 октября в 13:00 и в 14:40 — лекционое время
- 10-12 тестовых вопросов [ варианты ответа и краткий ]
- 3-4 задачи [ краткое письменное решение ]
- длительность — 80 минут [ на одну пару ]
материалы и semi-open book
асимптотический анализ, рекурсия, разделяй-и-властвуй, линейные контейнеры, алгоритмы сортировки, ...
- краткий письменный / печатный конспект
- определения и формулировки утверждений / теорем
                                // Лекция 06 завершена
                                // Резюме основных моментов
что мы
рассмотрели сегодня:
-
алгоритм Лас-Вегас: случайное время работы
быстрая сортировка
и вероятностный анализ ее сложности -
ADT Очереди с приоритетами
реализация интерфейса типа данных и
пирамидальная сортировка -
сортировки на основе сравнений [ cb-сортировки ]
дерево решений и утверждение о
нижней границе количества сравнений
--> на следующей лекции
--> специализированные линейные сортировки
                            };
                            return 0;
06->