                            class Algorithms {
                            public:
                                Algorithms lecture {
                                    .author = "Р.А. Нестеров"
                                    .year = "2026/27"
                                    .course = "НИУ ВШЭ ПИ, 2 курс"
                                };
алгоритмы
и структуры данных
                                // 01. Умножение целых чисел большой разрядности: алгоритмы
                                // «разделяй-и-властвуй» на основе интерполяции многочлена
                                void multiply_dac(const BigInt& a, constr BigInt& b);
                                // 02. Умножение квадратных матриц: алгоритмы
                                // «разделяй-и-властвуй» на основе блочного разбиения
                                void multiply_dac(const Matrix& A, const Matrix& B);
                                // 03. Первая мастер-теорема: быстрый вывод асимптотической
                                // границы по виду рекуррентного соотношения
                                void master_theorem();
->04
04.00
краткая ретроспектива
и повторение
рекуррентное соотношение: сложность рекурсии
разделяй-и-властвуй: некоторые приемы
параллельного выполнения алгоритмов в C++
                                    #include <algorithm>

                                    template<typename Iter>
                                    void selection_sort(Iter first, Iter last) {
                                        if (std::distance(first, last) <= 1) return;

                                        auto min_iter = std::min_element(first, last);
                                        std::iter_swap(first, min_iter);

                                        selection_sort(first + 1, last);
                                    }
$T(n) = \begin{cases} \mathrm{O}(1) & n \leqslant 1 \\ T(n-1) + kn & n > 1 \end{cases}$
                                        #include <algorithm>

                                        template<typename Iter>
                                        void merge_sort(Iter first, Iter last) {
                                            if (std::distance(first, last) <= 1) return;
                                            auto mid = first + std::distance(first, last) / 2;

                                            merge_sort(first, mid);
                                            merge_sort(mid, last);
                                            merge(first, mid, last);
                                        }
$T(n) = \begin{cases} \mathrm{O}(1) & n \leqslant 1 \\ T(\lfloor n\,/\,2\rfloor) + T(\lceil n\,/\,2\rceil) + kn & n > 1 \end{cases}$
void execute_parallel();
агрегация большого массива
однопоточная реализация с помощью std::accumulate
                                        #include <iostream>
                                        #include <vector>
                                        #include <numeric>
                                        #include <execution>
                                        #include <thread>
                                        #include <chrono>
                                        #include <random>

                                        using namespace std::chrono_literals;
                                        using clocks = std::chrono::high_resolution_clock;

                                        template<typename F>
                                        auto measure(F&& f) {
                                            auto start = clocks::now();
                                            auto result = f();
                                            auto end = clocks::now();
                                            auto ms = (end - start) / 1ms;
                                            return std::pair{result, ms};
                                        }

                                        long long sum_accumulate(const std::vector<int>& data) {
                                            return std::accumulate(data.begin(), data.end(), 0LL);
                                        }

                                        int main() {
                                            const size_t n = 500'000'000;
                                            std::vector<int> data(n);

                                            std::mt19937 rng(42);
                                            std::uniform_int_distribution<int> dist(1, 100);
                                            for (auto& v : data) v = dist(rng);

                                            auto [sum1, ms1] = measure([&] {
                                              return sum_accumulate(data);
                                            });

                                            return 0;
                                        }
последовательная агрегация
вычисление суммы 500 млн чисел — ~511 мс (~114 мс с -O2)
- линейный проход по массиву
- строгий порядок вычислений слева направо
- один поток для большого объема вычислений
void execute_parallel();
агрегация большого массива
стандартный параллелизм с политиками выполнения в std::reduce
                                        #include <iostream>
                                        #include <vector>
                                        #include <numeric>
                                        #include <execution>
                                        #include <thread>
                                        #include <chrono>
                                        #include <random>

                                        using namespace std::chrono_literals;
                                        using namespace std::execution;
                                        using clocks = std::chrono::high_resolution_clock;

                                        template<typename F>
                                        auto measure(F&& f) {
                                            auto start = clocks::now();
                                            auto result = f();
                                            auto end = clocks::now();
                                            auto ms = (end - start) / 1ms;
                                            return std::pair{result, ms};
                                        }

                                        long long sum_seq(const std::vector<int>& data) {
                                            return std::reduce(
                                                seq, data.begin(), data.end(), 0LL
                                            );
                                        }

                                        long long sum_par(const std::vector<int>& data) {
                                            return std::reduce(
                                                par, data.begin(), data.end(), 0LL
                                            );
                                        }

                                        long long sum_par_unseq(const std::vector<int>& data) {
                                            return std::reduce(
                                                par_unseq, data.begin(), data.end(), 0LL
                                            );
                                        }

                                        int main() {
                                            const size_t n = 500'000'000;
                                            std::vector<int> data(n);

                                            std::mt19937 rng(42);
                                            std::uniform_int_distribution<int> dist(1, 100);
                                            for (auto& v : data) v = dist(rng);

                                            auto [sum1, ms1] = measure([&] {
                                                return sum_seq(data);
                                            });

                                            auto [sum2, ms2] = measure([&] {
                                                return sum_par(data);
                                            });

                                            auto [sum3, ms3] = measure([&] {
                                                return sum_par_unseq(data);
                                            });

                                            return 0;
                                        }
делегирование библиотеке
- par — многопоточная реализация
- par_unseq — многопоточная реализация и SIMD
- необходима ассоциативная и коммутативная операция
| без -O2 (мс) | c -O2 (мс) | |
|---|---|---|
| std::accumulate | 511 | 114 |
| std::reduce(seq) | 908 | 43 |
| std::reduce(par) | 910 | 42 |
| std::reduce(par_unseq) | 1231 | 128 |
void execute_parallel();
агрегация большого массива
присоединяемые потоки выполнения std::jthread из C++20
                                        #include <iostream>
                                        #include <vector>
                                        #include <numeric>
                                        #include <execution>
                                        #include <thread>
                                        #include <chrono>
                                        #include <random>

                                        using namespace std::chrono_literals;
                                        using namespace std::execution;
                                        using clocks = std::chrono::high_resolution_clock;

                                        template<typename F>
                                        auto measure(F&& f) {
                                            auto start = clocks::now();
                                            auto result = f();
                                            auto end = clocks::now();
                                            auto ms = (end - start) / 1ms;
                                            return std::pair{result, ms};
                                        }

                                        static constexpr size_t kTHRESHOLD = 100'000;
                                        static constexpr int    kMAX_DEPTH = 4;

                                        long long partial_sum(const std::vector<int>& data,
                                                              size_t start,
                                                              size_t end)
                                        {
                                            return std::accumulate(
                                                data.begin() + start, data.begin() + end, 0LL
                                            );
                                        }

                                        void dac_worker(const std::vector<int>& data,
                                                        size_t start, size_t end,
                                                        int depth,
                                                        long long& result)
                                        {
                                            const size_t length = end - start;

                                            if (length <= kTHRESHOLD || depth >= kMAX_DEPTH) {
                                                result = partial_sum(data, start, end);
                                                return;
                                            }

                                            size_t mid = start + length / 2;
                                            long long left_sum = 0, right_sum = 0;

                                            std::jthread left_thread([&]() {
                                                dac_worker(data, start, mid, depth + 1, left_sum);
                                            });
                                            dac_worker(data, mid, end, depth + 1, right_sum);
                                            left_thread.join();

                                            result = left_sum + right_sum;
                                        }

                                        long long sum_jthread(const std::vector<int>& data) {
                                            long long total = 0;
                                            dac_worker(data, 0, data.size(), 0, total);
                                            return total;
                                        }

                                        int main() {
                                            const size_t n = 500'000'000;
                                            std::vector<int> data(n);

                                            std::mt19937 rng(42);
                                            std::uniform_int_distribution<int> dist(1, 100);
                                            for (auto& v : data) v = dist(rng);

                                            auto [sum1, ms1] = measure([&] {
                                                return sum_jthread(data);
                                            });

                                            return 0;
                                        }
«разделяй-и-властвуй» воркер
- полный контроль над гранулярностью и глубиной рекурсии
- безопасность жизненного цикла и кооперативная отмена
- асимметричный параллелизм для баланса нагрузки
| без -O2 (мс) | c -O2 (мс) | |
|---|---|---|
| std::accumulate | 511 | 114 |
| std::reduce(seq) | 908 | 43 |
| std::reduce(par) | 910 | 42 |
| std::reduce(par_unseq) | 1231 | 128 |
| std::jthread | 94 | 23 |
неделя №4
--> квиз Л3
04.01
умножение целых чисел
переход к задаче умножения многочленов
алгоритм Карацубы: интерполяция коэффициентов многочлена второй степени
базовый алгоритм Тоома-Кука: интерполяция коэффициентов многочлена четвертой степени
практические вопросы применимости алгоритмов
и теоретические пределы
задача 04.01
вычислить произведение двух целых чисел одинаковой
длины $n$ в системе счисления по основанию $\beta$:
- $a = a_{n-1}a_{n-2}\dots a_1a_0 = \sum\limits_{i=0}^{n-1} a_i \cdot \beta^i$
- $b = b_{n-1}b_{n-2}\dots b_1b_0 = \sum\limits_{i=0}^{n-1} b_i \cdot \beta^i$
для всех разрядов $a_i$ и $b_i$ верно, что $0 \leqslant a_i < \beta$ и $0 \leqslant b_i < \beta$
решение — умножение в столбик
применяем наивный подход к умножению чисел $a$ и $b$:
- $c = a \cdot b = \sum\limits_{i=0}^{n-1} \sum\limits_{j=0}^{n-1} a_i \cdot b_j \cdot \beta^{i+j}$
-
$c = \sum\limits_{k =0}^{2n-1} \tilde{c}_k \cdot \beta^k = \tilde{c}_{2n-1}\tilde{c}_{2n-2}\dots \tilde{c}_1 \tilde{c}_0$,
где $\tilde{c}_k$ — цифра результата в системе счисления по основанию $\beta$, полученная с учетом переносов
сложность умножения целых чисел
сложность $T(n)$ умножения складывается из:
- $n^2$ поразрядных умножений
- $(n-1)^2$ поразрядных сложений
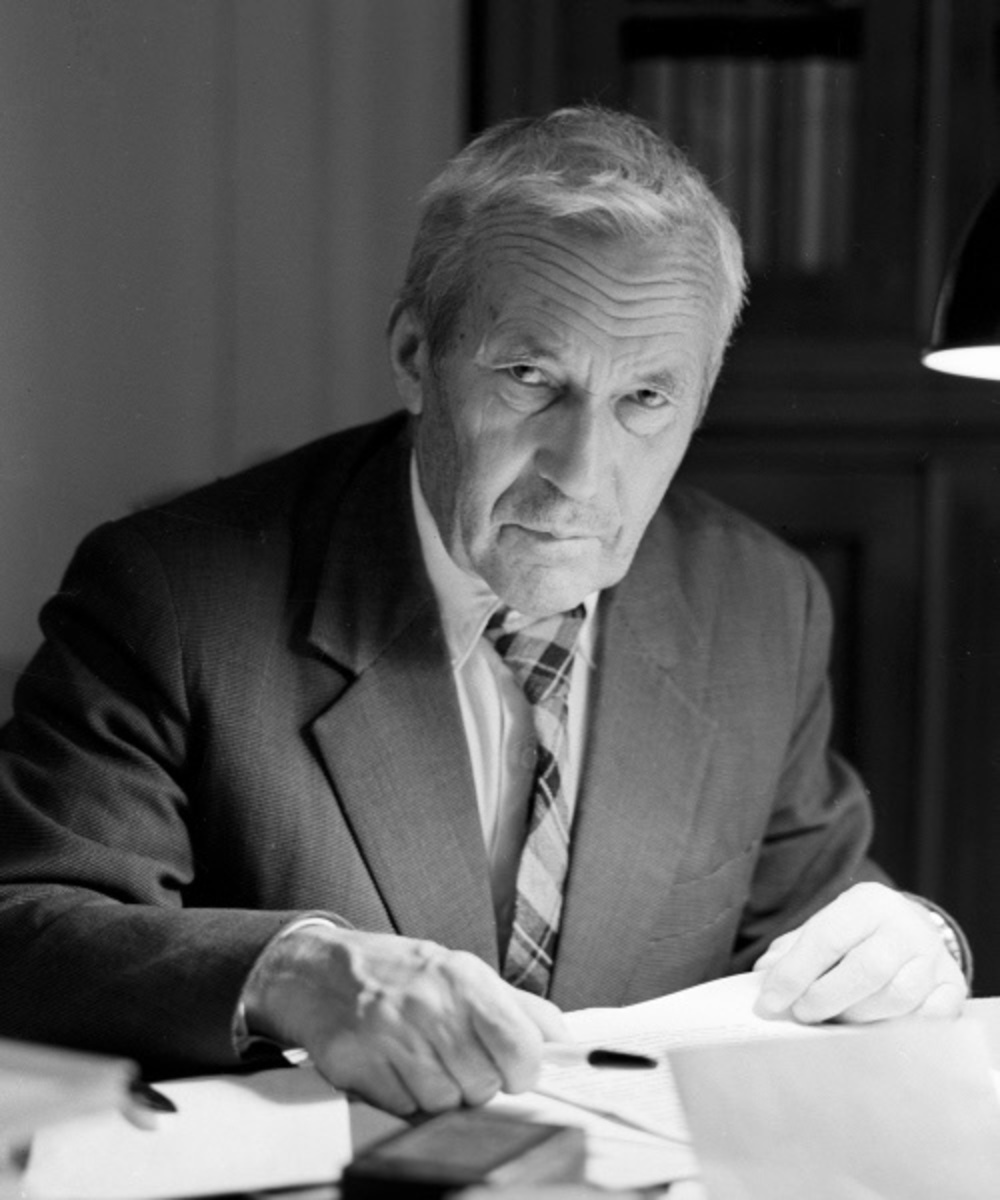
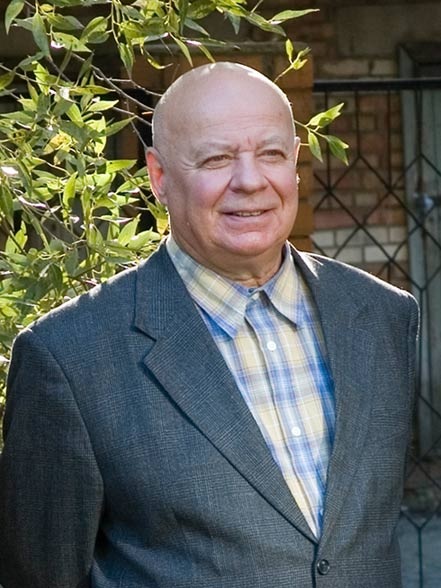
в середине 1950-х годов А.Н. Колмогоров выдвинул гипотезу, что $T(n) = \Omega(n^2)$, которая была опровергнута уже в 1960 году А.А. Карацубой, научным воспитанником Колмогорова
задача 04.01
вычислить произведение двух целых чисел одинаковой
длины $n$ в системе счисления по основанию $\beta$:
- $a = a_{n-1}a_{n-2}\dots a_1a_0 = \sum\limits_{i=0}^{n-1} a_i \cdot \beta^i$
- $b = b_{n-1}b_{n-2}\dots b_1b_0 = \sum\limits_{i=0}^{n-1} b_i \cdot \beta^i$
для всех разрядов $a_i$ и $b_i$ верно, что $0 \leqslant a_i < \beta$ и $0 \leqslant b_i < \beta$
решение — умножение многочленов
сопоставим числам $a$ и $b$ многочлены степени $n-1$:
- $A(x) = \sum\limits_{i=0}^{n-1} a_i\cdot x^i \Rightarrow a = A(\beta)$
- $B(x) = \sum\limits_{i=0}^{n-1} b_i\cdot x^i \Rightarrow b = B(\beta)$
необходимо вычислить коэффициенты многочлена:
$C(x) = A(x)\cdot B(x) = \sum\limits_{i=0}^{n-1} \sum\limits_{j=0}^{n-1} a_i \cdot b_j \cdot x^{i+j}$основная теорема алгебры
любой многочлен $P(x)$ степени $n-1$ однозначно определяется значениями в $n$ различных точках $P(x_0), P(x_1), \dots, P(x_{n-1})$
решение — интерполяция многочленов
вычисление коэффициентов многочлена-произведения $C(x) = A(x)\cdot B(x)$ сводится к:
-
вычислению значений $A(x)$ и
$B(x)$ в $2n - 1$ различной точке $k_0, k_1, \dots, k_{2n-2}$ -
вычислению $2n - 1$
поточечных произведений $C(k_i) = A(k_i)\cdot B(k_i)$ -
интерполяции коэффициентов
многочлена $C(x)$ по значениям $C(k_i)$ ${c}_0, {c}_1, \dots, {c}_{2n-2}$
ответ $\{{c}_0, {c}_1, \dots, {c}_{2n-2}\}$, а также $a\cdot b = C(\beta)$
void multiply_dac(const BigInt& a, const BigInt& b);
алгоритм Карацубы
разделяй-и-властвуй умножение чисел / многочленов
задача 04.01
вычислить произведение двух целых чисел длины $n$:
- $a = a_{n-1}a_{n-2}\dots a_1a_0 = \sum\limits_{i=0}^{n-1} a_i \cdot \beta^i$
- $b = b_{n-1}b_{n-2}\dots b_1b_0 = \sum\limits_{i=0}^{n-1} b_i \cdot \beta^i$
решение — умножение многочленов
сопоставим числам $a$ и $b$ многочлены первой степени:
- $A(x) = a_1'\cdot x + a_0'$ $a_1' = a_{n-1}\dots a_{n\,/\,2}$ $a_0' = a_{n\,/\,2-1}\dots a_{0}$
- $B(x) = b_1'\cdot x + b_0'$ $b_1' = b_{n-1}\dots b_{n\,/\,2}$, $b_0' = b_{n\,/\,2-1}\dots b_{0}$
таким образом, $C(x) = A(x) \cdot B(x) = c_0 + c_1\cdot x + c_2 \cdot x^2$
решение — интерполяция многочленов
-
вычисляем $A(x)$ и $B(x)$
в трех выбранных точках $k_0 = 0, k_1 = 1, k_{2} = \infty$$A(0)=a_0'$ | $A(1)=a_0'+a_1'$ | $A(\infty)=a_1'$
с помощью матричного представления:
$\begin{aligned} \begin{pmatrix} A(0) \\[0.5ex] A(1) \\[0.5ex] A(\infty) \end{pmatrix}&= \begin{pmatrix} k_0^0 & k_0^1 \\[0.5ex] k_1^0 & k_1^1 \\[0.5ex] 0 & 1 \end{pmatrix} \cdot \begin{pmatrix} a_0' \\[0.5ex] a_1' \end{pmatrix}= \begin{pmatrix} 0^0 & 0^1 \\ 1^0 & 1^1 \\ 0 & 1 \end{pmatrix} \cdot \begin{pmatrix} a_0' \\[0.5ex] a_1' \end{pmatrix} \end{aligned}$
$\begin{aligned} \phantom{ \begin{pmatrix} A(0) \\[0.5ex] A(1) \\[0.5ex] A(\infty) \end{pmatrix}}&= \begin{pmatrix} 1 & 0 \\ 1 & 1 \\ 0 & 1 \end{pmatrix} \cdot \begin{pmatrix} a_0' \\[0.5ex] a_1' \end{pmatrix} = \begin{pmatrix} a_0' \\[0.5ex] a_0' + a_1' \\[0.5ex] a_1' \end{pmatrix} \end{aligned}$
- рекурсивно вычисляем поточечные произведения $C(0)=a_0' b_0'$ | $C(1)=(a_0'+a_1')(b_0'+b_1')$ | $C(\infty)=a_1' b_1'$
-
интерполируем коэффициенты многочлена $C(x)$
$c_0=c(0)$ | $c_1=C(1)-c_0-c_2$ | $c_2=C(\infty)$
с помощью матрицы Вандермонда ($k_0 = 0, k_1 = 1, k_{2} = \infty$):
$\begin{aligned} \begin{pmatrix} C(0) \\[0.5ex] C(1) \\[0.5ex] C(\infty) \end{pmatrix}&= \begin{pmatrix} k_0^0 & k_0^1 & k_0^2 \\[0.5ex] k_1^0 & k_1^1 & k_1^2 \\[0.5ex] 0 & 0 & 1 \end{pmatrix} \cdot \begin{pmatrix} c_0 \\[0.5ex] c_1 \\[0.5ex] c_2 \end{pmatrix} \end{aligned}$
умножим справа на обратную матрицу Вандермонда:
$\begin{aligned} \begin{pmatrix} c_0 \\[0.5ex] c_1 \\[0.5ex] c_2 \end{pmatrix} = \begin{pmatrix} 1 & 0 & 0 \\[0.5ex] 1 & 1 & 1 \\[0.5ex] 0 & 0 & 1 \end{pmatrix}^{-1} \cdot \begin{pmatrix} C(0) \\[0.5ex] C(1) \\[0.5ex] C(\infty) \end{pmatrix} \end{aligned}$
получим коэффициенты:
$\begin{aligned} \begin{pmatrix} c_0 \\[0.5ex] c_1 \\[0.5ex] c_2 \end{pmatrix} = \begin{pmatrix} C(0) \\[0.5ex] C(1)-C(0)-C(\infty) \\[0.5ex] C(\infty) \end{pmatrix} \end{aligned}$
ответ $\{c_0, c_1, c_2\}$, а также $a\cdot b = C(\beta\,/\,2)$
полное рекуррентное соотношение
параметры дерева рекурсии
- высота / число уровней $h = \mathrm{O}(\log_2 n)$
- сложность $i$-го уровня $3^i\cdot kn\,/\,2^i$
-
общая сложность:
$$\sum\limits_{i=0}^{h} kn \cdot \left(\frac{3}{2}\right)^i = kn \left(\frac{3^{h+1}}{2^h}-2\right) = \mathrm{O}(3^h) = \mathrm{O}(n^{\log_2 3})$$
практические замечания
- накладные расходы на разбиение чисел
-
выбор порога переключения на обычное умножение
[ диапазон 32-128 показывает разницу времени около 20% ] -
продакшен-подход
[ основание $\beta = 2^{64}$ и порог 30-60 слов ]
void multiply_dac(const BigInt& a, const BigInt& b);
алгоритм Тоома-Кука
разделяй-и-властвуй умножение чисел / многочленов
задача 04.01
вычислить произведение двух целых чисел одинаковой
длины $n$ в системе счисления по основанию $\beta$:
- $a = a_{n-1}a_{n-2}\dots a_1a_0 = \sum\limits_{i=0}^{n-1} a_i \cdot \beta^i$
- $b = b_{n-1}b_{n-2}\dots b_1b_0 = \sum\limits_{i=0}^{n-1} b_i \cdot \beta^i$
решение — умножение многочленов
сопоставим числам $a$ и $b$ многочлены второй степени:
- $A(x) = a_0' + a_1'\cdot x + a_2'\cdot x^2 \Rightarrow a = A(\beta^{n\,/\,3})$
- $B(x) = b_0' + b_1'\cdot x + b_2'\cdot x^2 \Rightarrow b = B(\beta^{n\,/\,3})$
решение — интерполяция многочленов
-
вычисляем $A(x)$ и $B(x)$
в пяти выбранных точках $k_0 = 0, k_1=1, k_2 = -1,$
$k_3 = -2, k_4 = \infty$ $A(0)=a_0'$ | $A(1)=a_0'+a_1'+a_2'$ | $A(-1)=\dots$ | $\dots$ - рекурсивно вычисляем поточечные произведения $С(0)=a_0'\cdot b_0'$ | $C(1)=(a_0'+a_1'+a_2')(b_0'+b_1'+b_2')$ | $\dots$
-
интерполируем коэффициенты $C(x)$ с помощью
обратной матрицы Вандермонда размерности $5 \times 5$ $c_0 = C(0)$ | $c_4 = C(\infty)$ | $\dots$
ответ $\{c_0, c_1, c_2, c_3, c_4\}$, а также $a\cdot b = C(\beta^{n\,/\,3})$
полное рекуррентное соотношение

параметры дерева рекурсии
- высота / число уровней $h = \mathrm{O}(\log_3 n)$
- сложность $i$-го уровня $5^i\cdot kn\,/\,3^i$
-
общая сложность:
$$\sum\limits_{i=0}^{h} kn \cdot \left(\frac{5}{3}\right)^i = \frac{kn}{2} \left(\frac{5^{h+1}}{3^h}-3\right) = \mathrm{O}(5^h) = \mathrm{O}(n^{\log_3 5})$$
практические замечания
-
расходы на интерполяцию коэффициентов
доминируют над ветвлением - выбор порога переключения THR на обычное умножение оказывает меньшее влияние на время работы
-
продакшен-подход
[ основание $\beta = 2^{64}$ и порог 1000 слов ]
| год | алгоритм | сложность | инструмент |
|---|---|---|---|
| 1962 | Карацуба | $\mathrm{O}(n^{1.585})$ | многочлены первой степени |
| 1963 | Тоом-Кук-$k$ | $\mathrm{O}(n^{\log_{k} (2k-1)})$ | многочлены степени $k-1$ |
| 1971 | Шёнхаге-Штрассен | $\mathrm{O}(n \log n \log \log n)$ | преобразование Фурье |
| 2007 | Fürer | $\mathrm{O}(n \log n \cdot 2^{\mathrm{O}(\log^* n)})$ | преобразование Фурье+ |
| 2019 | Харви-ван дер Хувен | $\mathrm{O}(n \log n)$ | преобразование Фурье++ |
галлактический алгоритм
04.02
умножение
квадратных матриц
наивный алгоритм: сумма произведений
блочный «разделяй-и-властвуй» алгоритм и его практические усовершенствования
алгоритм Штрассена: сложные линейные комбинации
BLAS: высокопроизводительная промышленная библиотека для операций линейной алгебры
определение «строка-на-столбец»
                                        #include <vector>

                                        template<typename T>
                                        using Matrix = std::vector<std::vector<T>>;

                                        template<typename T>
                                        Matrix<T> multiply(const Matrix<T>& A, const Matrix<T>& B) {
                                            size_t n = A.size();
                                            Matrix<T> C(n, std::vector<T>(n, 0));

                                            for (size_t i = 0; i < n; ++i) {
                                                for (size_t j = 0; j < n; ++j) {
                                                    for (size_t k = 0; k < n; ++k) {
                                                        C[i][j] += A[i][k] * B[k][j];
                                                    }
                                                }
                                            }

                                            return C;
                                        }

КЭШ-ПРОМАХИ!
- внутренний цикл по k постоянно переходит в другие области памяти, которые еще не загружены в кэш процессора
- поменять местами порядок циклов на i->k->j
- перейти к представлению матрицы B в виде массивов столбцов, а не строк [ column-major order ]

экспериментальная оценка
- время работы матричного умножения $t$
-
GFLOPS — миллиард операций
с плавающей точкой в секунду
GFLOPS(n) $=2 \cdot n^3 \,/\, (t \cdot 10^9)$ - матрица в виде одного вектора std::vector<double>
- замеры с помощью библиотеки Google Benchmark
| наивный (мс) | c.-f. (мс) | ускорение | |
|---|---|---|---|
| 32 | 0.009 | 0.005 | 1.94x |
| 64 | 0.088 | 0.047 | 1.86x |
| 128 | 1.03 | 0.482 | 2.12x |
| 256 | 10.1 | 5.12 | 1.96x |
| 512 | 102 | 53.1 | 1.92x |
| 1024 | 881 | 281 | 1.85x |
| 2048 | 18824 | 4257 | 4.4x |
| 4096 | 213559 | 35005 | 6.03x |
определение «блочное умножение»
$ \left( \begin{array}{c|c} A_{11}\cdot B_{11} + A_{12} \cdot B_{21}& A_{11} \cdot B_{12} + A_{12} \cdot B_{22}\\ \hline A_{21} \cdot B_{11} + A_{22} \cdot B_{21} & A_{21} \cdot B_{12} + A_{22} \cdot B_{22} \end{array} \right)$
                                        #include <vector>

                                        template<typename T>
                                        using Matrix = std::vector<std::vector<T>>;

                                        template<typename T>
                                        void multiply_dac(const Matrix<T>& A, int ar, int ac,
                                                          const Matrix<T>& B, int br, int bc,
                                                          Matrix<T>& C, int cr, int cc,
                                                          int size)
                                        {
                                            if (size == 1) {
                                                C[cr][cc] += A[ar][ac] * B[br][bc];
                                                return;
                                            }
                                            int h = size / 2;

                                            // C11 = A11*B11 + A12*B21
                                            mult_block(A, ar,   ac,   B, br,   bc,   C, cr,   cc,   h);
                                            mult_block(A, ar,   ac+h, B, br+h, bc,   C, cr,   cc,   h);
                                            // C12 = A11*B12 + A12*B22
                                            mult_block(A, ar,   ac,   B, br,   bc+h, C, cr,   cc+h, h);
                                            mult_block(A, ar,   ac+h, B, br+h, bc+h, C, cr,   cc+h, h);
                                            // C21 = A21*B11 + A22*B21
                                            mult_block(A, ar+h, ac,   B, br,   bc,   C, cr+h, cc,   h);
                                            mult_block(A, ar+h, ac+h, B, br+h, bc,   C, cr+h, cc,   h);
                                            // C22 = A21*B12 + A22*B22
                                            mult_block(A, ar+h, ac,   B, br,   bc+h, C, cr+h, cc+h, h);
                                            mult_block(A, ar+h, ac+h, B, br+h, bc+h, C, cr+h, cc+h, h);
                                        }

                                        template<typename T>
                                        Matrix<T> multiply(const Matrix<T>& A, const Matrix<T>& B) {
                                            size_t dim = A.size();
                                            Matrix<T> C(dim, std::vector<T>(dim, 0));

                                            multiply_dac(A, 0, 0, B, 0, 0, C, 0, 0, dim);
                                            return C;
                                        }
задача 04.02
решение — математическая индукция
-
основное
предположение: $T(n) = \mathrm{O}(n^3) \Rightarrow$
$T(n) \leqslant cn^3 - dn^2$, где $d < c$ - гипотеза индукции: $\forall m < n \colon T(m) \leqslant cm^3 - dm^2$
-
выполним подстановку:
$\begin{aligned} T(n) & \leqslant 8c(n\,/\,2)^3 - 8d(n\,/\,2)^2 + kn^2\end{aligned}$
$\begin{aligned} \phantom{T(n)} &\leqslant cn^3 - (2d -k)n^2 \leqslant cn^3 - dn^2 \end{aligned}$
- $2d - k \geqslant d \Rightarrow d \geqslant k$
ответ $T(n) = \mathrm{O}(n^3)$ при $d = k$, $c = k + 1$ и $n \geqslant 0$
важно отметить
экспериментальная оценка
- fork-join — порождение заданного числа потоков на верхнем уровне, статическое распределение блоков и ожидание завершения в главном потоке
- потоки работают в независимых областях памяти
- матрица в виде одного вектора std::vector<double>
- замеры с помощью библиотеки Google Benchmark
| GFLOPS (8 пот.) | $\times$ к наивному | $\times$ к c.-f. | |
|---|---|---|---|
| 32 | 1.4 | 0.2 | 0.1 |
| 64 | 9.7 | 1.7 | 0.9 |
| 128 | 39.6 | 10 | 4.7 |
| 256 | 54.1 | 17 | 8.5 |
| 512 | 53.5 | 21 | 11 |
| 1024 | 52 | 22 | 12 |
| 2048 | 54.2 | 55 | 13 |
| 4096 | 50.9 | 78 | 13 |
void multiply_dac(const Matrix& A, const Matrix& B);
алгоритм Штрассена
выигрываем одно рекурсивное умножение
теорема Ш. Винограда (1971)
для перемножения двух матриц размерности $2 \times 2$ необходимо и достаточно 7 умножений
задача 04.03
разработать такой рекурсивный алгоритм перемножения двух матриц $A$ и $B$ размерности $n \times n$, что число рекурсивных умножений блоков матриц составляет 7:
$T(n) = \begin{cases} \mathrm{O}(1) & n \leqslant 1 \\ 7\cdot T(n\,/\,2) + kn^2 & n > 1 \end{cases}$
решение
-
вычисляем 10 вспомогательных сумм
$S_1$ | $S_2$ |$S_3$|$S_4$|$S_5$ |$S_6$|$S_7$|$S_8$|$S_9$|$S_{10}$
- $S_1 = B_{12}-B_{22}$
- $S_2 = A_{11}+A_{12}$
- $S_3 = A_{21}+A_{22}$
- $S_4 = B_{21}-B_{11}$
- $S_5 = A_{11}+A_{22}$
- $S_6 = B_{11}+B_{22}$
- $S_7 = A_{12}-A_{22}$
- $S_8 = B_{21}+B_{22}$
- $S_9 = A_{11}-A_{21}$
- $S_{10} = B_{11}+B_{12}$
-
рекурсивно вычисляем 7 главных произведений
$P_1$ | $P_2$ |$P_3$|$P_4$|$P_5$ |$P_6$|$P_7$
- $P_1 = A_{11}\cdot S_{1}$
- $P_2 = S_{2}\cdot B_{22}$
- $P_3 = S_3\cdot B_{11}$
- $P_4 = A_{22}\cdot S_{4}$
- $P_5 = S_{5}\cdot S_{6}$
- $P_6 = S_{7}\cdot S_{8}$
- $P_7 = S_{9}\cdot S_{10}$
-
вычисляем блоки матрицы $C$
$C_{11}$ | $C_{12}$ |$C_{21}$|$C_{22}$
- $C_{11} = P_5 + P_4 - P_2 + P_6$
- $C_{12} = P_1 + P_2$
- $C_{21} = P_3 + P_4$
- $C_{22} = P_5 + P_1 - P_3 - P_7$
$\left( \begin{array}{c|c} A_{11} & A_{12} \\ \hline A_{21} & A_{22} \end{array} \right) \cdot \left( \begin{array}{c|c} B_{11} & B_{12} \\ \hline B_{21} & B_{22} \end{array} \right) = \left( \begin{array}{c|c} C_{11} & C_{12} \\ \hline C_{21} & C_{22} \end{array} \right)$

параметры дерева рекурсии алгоритма штрассена
- высота / число уровней $h = \mathrm{O}(\log_2 n)$
- сложность $i$-го уровня $7^i\cdot kn^2\,/\,4^i$
- общая сложность: $\displaystyle\sum\limits_{i=0}^{h} kn^2 \cdot \left(\frac{7}{4}\right)^i = \frac{kn^2}{3} \left(\frac{7^{h+1}}{4^h}-4\right) = \mathrm{O}(7^h) = \mathrm{O}(n^{\log_2 7})$
экспериментальная оценка
- однопоточная реализация алгоритма Штрассена
- настройка порога переключения на другой алгоритм
- матрица в виде одного вектора std::vector<double>
- замеры с помощью библиотеки Google Benchmark
| GFLOPS (Штр-64) | GFLOPS (блочн.) | $\times$ | |
|---|---|---|---|
| 256 | 22.1 | 14.9 | 1.5 |
| 512 | 24.7 | 13.2 | 1.9 |
| 1024 | 27.3 | 11.4 | 2.4 |
| 2048 | 28.8 | 10.9 | 2.7 |
| 4096 | 34.7 | 10.8 | 3.2 |
асимптотика? асимптотика!
- Штр-64 $3 - p = \log_2 (34.7\,/\,22.1)/4 = 0.16 \Rightarrow p = 2.84$
- блочный $3 - p = \log_2 (10.8\,/\,14.9)/4 = -0.12 \Rightarrow p = 3.12$
ПРОДАКШЕН-БИБЛИОТЕКА СBLAS
- высокопроизводительная библиотека с операциями линейной алгебры
- SIMD-микрокернелы, packing и пул потоков
- матрица в виде одного вектора std::vector<double>
- замеры с помощью библиотеки Google Benchmark
| $\times$ к наивному | $\times$ к блочн.-8 | $\times$ к Штр-64 | |
|---|---|---|---|
| 32 | 27 | 150 | — |
| 64 | 69 | 40 | — |
| 128 | 112 | 11 | — |
| 256 | 142 | 9 | 21 |
| 512 | 166 | 8 | 18 |
| 1024 | 185 | 9 | 17 |
| 2048 | 456 | 9 | 16 |
| 4096 | 707 | 9 | 13 |
| год | алгоритм | $\mathrm{O}(n^{p})$ | инструмент |
|---|---|---|---|
| 1812 | Бине | $p=3.000$ | строка-на-столбец |
| 1969 | Штрассен | $p=2.807$ | 7 специальных умножений |
| 1978 | Пан | $p=2.796$ | специальные разбиения и трилинейные агрегации |
| 1979 | Бини и др. | $p=2.780$ | приближенные умножения |
| 1981 | Шёнхаге | $p=2.522$ | частичные умножения и крупные тензоры |
| 1990 | Копперсмит-Виноград | $p=2.376$ | лазерный метод |
| 2010 | Стозерс | $p=2.3737$ | лазерный метод+ |
| 2020 | Алман-Уильямс | $p=2.37286$ | лазерный метод++ |
| 2022 | DeepMind | $-$ | улучшение Штрассена на малых матрицах |
| 2024 | Дуань-Ву-Чжоу | $p = 2.37134$ | лазерный метод+++ |
| 2026 | DeepMind | $p =2.37118$ | лазерный метод++++ |
и опять галлактический алгоритм
04.03
первая мастер-теорема
рекуррентные соотношения вида «разделяй-и-властвуй» $T(n) = a\cdot T(n\,/\,b) + \mathrm{O}(n^k \cdot f(n))$
быстрое вычисление аспимтотической границы $T(n)$
задача 04.04
выразить в общем виде решение рекуррентного соотношения
$T(n) = a \cdot T\left(\dfrac{n}{b}\right) + \mathrm{O}(n^k \cdot f(n))$, где:
- $a \geqslant 1$ — фактор ветвления, количество подзадач
- $b > 1$ — коэффициент уменьшения размера задачи
-
$k \geqslant 0$ — порядок полиномиального роста затрат
на слияние решений подзадач - $f(n)$ — монотонная, $\forall m < n \colon f(m) \leqslant f(n)$
решение — итерационный метод
$\begin{aligned} T(n) &\leqslant a \cdot T\left(\dfrac{n}{b}\right) + c n^k f(n) \end{aligned}$
$\begin{aligned} \phantom{T(n)} &\leqslant a\left(a \cdot T\left(\dfrac{n}{b^2}\right) + c\left(\dfrac{n}{b}\right)^k f\left(\frac{n}{b}\right) \right) + c n^k f(n) \end{aligned}$
$\begin{aligned} \phantom{T(n)} &= a^2 \cdot T\left(\dfrac{n}{b^2}\right) + cn^k \left( f(n) + \left(\frac{a}{b^k} \right)f\left(\frac{n}{b}\right)\right) \end{aligned}$
$\begin{aligned} \phantom{T(n)} &= a^3 \cdot T\left(\dfrac{n}{b^3}\right) + cn^k \left( f(n) + \left(\frac{a}{b^k} \right) f\left(\frac{n}{b}\right) + \left(\frac{a}{b^k} \right)^2 f\left(\frac{n}{b^2}\right)\right) \end{aligned}$
$\begin{aligned} \phantom{T(n)} &= \dots \end{aligned}$
$\begin{aligned} \phantom{T(n)} &= a^h \cdot T\left(\dfrac{n}{b^h}\right) + cn^k \cdot \sum\limits_{i = 0}^{h-1}\left(\frac{a}{b^k} \right)^i f\left(\frac{n}{b^i}\right) \end{aligned}$
с учетом предельного значения $h = \log_b n$ получаем:$\begin{aligned} T(n) &= n^{\log_b a} \cdot \mathrm{O}(1) + \mathrm{O}(n^k \cdot f(n)) \cdot \sum\limits_{i = 0}^{\log_b-1}\left(\frac{a}{b^k} \right)^i \end{aligned}$
void master_theorem();
первая мастер-теорема
быстрый анализ рекуррентных соотношений «разделяй-и-властвуй»
задача 04.04
выразить в общем виде решение рекуррентного соотношения
$T(n) = a \cdot T\left(\dfrac{n}{b}\right) + \mathrm{O}(n^k \cdot f(n))$, где:
- $a \geqslant 1$ — фактор ветвления, количество подзадач
- $b > 1$ — коэффициент уменьшения размера задачи
-
$k \geqslant 0$ — порядок полиномиального роста затрат
на слияние решений подзадач - $f(n)$ — монотонная, $\forall m < n \colon f(m) \leqslant f(n)$
решение — вывод случаев
$\begin{aligned} T(n) &= n^{\log_b a} \cdot \mathrm{O}(1) + \mathrm{O}(n^k \cdot f(n)) \cdot \sum\limits_{i = 0}^{\log_b n-1}\left(\frac{a}{b^k} \right)^i \end{aligned}$
сравниваем значения порядков $k$ и $\log_b a$:-
$k = \log_b a \Rightarrow T(n) = \mathrm{O}(n^k \cdot f(n) \cdot \log n)$
[ разделяй уравновешивается с властвуй ] -
$k < \log_b a \Rightarrow T(n) = \mathrm{O}(n^{\log_b a} \cdot f(n))$
[ разделяй доминирует над властвуй ] -
$k > \log_b a \Rightarrow T(n) = \mathrm{O}(n^k \cdot f(n))$
[ властвуй доминирует над разделяй ]
void master_theorem();
первая мастер-теорема
быстрый анализ рекуррентных соотношений «разделяй-и-властвуй»
теорема 04.01
$T(n) = \begin{cases} \mathrm{O}(1) & n \leqslant b \\ a \cdot T\left(\dfrac{n}{b}\right) + \mathrm{O}(n^k \cdot f(n)) & n > b \end{cases}$
верны следущие утверждения о сложности:- $k = \log_b a \Rightarrow T(n) = \mathrm{O}(n^k \cdot f(n) \cdot \log n)$
- $k < \log_b a \Rightarrow T(n) = \mathrm{O}(n^{\log_b a} \cdot f(n))$
- $k > \log_b a \Rightarrow T(n) = \mathrm{O}(n^k \cdot f(n))$
задача 04.05
найти верхнюю асимптотическую границу $\mathrm{O}(g(n))$ для соотношения $T(n) = T\left(\dfrac{n}{2}\right) + T\left(\dfrac{n}{4}\right) + cn\log n$
решение — выбор случая мастер-теоремы
в силу монотонности, $T\left(\dfrac{n}{b}\right) \leqslant T(n)$ для любого $b \geqslant 1$
- $T\left(\dfrac{n}{4}\right) \leqslant T\left(\dfrac{n}{2}\right) \Rightarrow T(n) \leqslant 2\cdot T\left(\dfrac{n}{2}\right)+ cn\log n$
- $a = 2$, $b = 2$, $k = 1$, $f(n) = \log n$
- $\log_b a = 1 = k \Rightarrow T(n) = \mathrm{O}(n^k \cdot f(n) \cdot \log n)$
ответ $g(n) = n \cdot \log^2 n$
                                // Лекция 04 завершена
                                // Резюме основных моментов
что мы
рассмотрели сегодня:
-
«разделяй-и-властвуй» алгоритм для умножения целых чисел
интерполяция коэффициентов многочлена некоторой степени
-
«разделяй-и-властвуй» алгоритмы для умножения матриц
блочное умножение и алгоритм Штрассена
-
первая мастер-теорема для решения рекуррентных соотношений
быстрый вывод сложности рекурсивного алгоритма
--> на следующей лекции
--> вторая мастер теорема, метод Акры-Баззи
--> и стохастические алгоритмы
                            };
                            return 0;
04->